Git から同期しているアプリケーション 15 件

Git 管理 · 最終確認 2026年9月

DevOps インフラエンジニア マルタ ITインフラ歴 8年以上

信頼できる基盤をつくり、デプロイも復旧も予測どおりに。

ITインフラ・ネットワーク・クラウド自動化の分野で8年以上。Altenar では Terraform・Ansible・Python で GCP 環境を自動化しています。個人では 4 ノードの K3s クラスタ(ベアメタルの Proxmox ホスト 1 台上の 4 VM)を 構築・運用し、その上で自作プロダクトを公開しています。

IT・インフラ歴
8年以上

企業勤務 · IT サポート → ネットワーク → DevOps

クラスタノード
4

個人基盤 · ホスト 1 台上の VM

同期アプリ
15

個人基盤 · ArgoCD が Git から同期

決済から起動まで
46

WyrmHost · テスト購入 1 件での実測値

職務経歴

IT サポート → ネットワーク → DevOps · 2016年から現在

在職歴 マルタ · 6 社

2024年3月 — 現在

セント・ジュリアン(マルタ)

DevOps インフラエンジニア · Altenar

GCP 環境をコードとして構築・自動化し、その周辺のネットワーク層も担当しています。

  • モジュール化した Terraform 構成と Ansible プレイブックにより、複数リージョンの GCP 環境を手作業ではなく再現可能・バージョン管理された形に。
  • 個別の運用ニーズに応じて PythonBash のスクリプトを作成し、手作業で回していた業務をチームから外しました。
  • Prometheus と Grafana による監視基盤とアラート自動化を導入し、SLI/SLO の追跡とポストモーテムの根拠を整備。
  • Docker によるワークロードのコンテナ化、Kubernetes のクラスタ設定・リソースポリシー・ローリングアップグレード。Vault による認証情報管理と最小権限の IAM。
  • ネットワーク層の担当: HAProxy によるロードバランシング、FortiGate のルールセット、DNS ゾーン、IPsec/SSL VPN ゲートウェイ。すべての変更を Bash 自動化でバージョン管理しています。
  • GCP
  • Terraform
  • Ansible
  • Python
  • Kubernetes
  • HAProxy
  • FortiGate
  • Vault

2022年10月 — 2024年3月

モスタ(マルタ)

ネットワーク管理者 · Smart Technologies

Fortinet・Mikrotik・Cisco・Aruba・Ruckus を用いた顧客環境のネットワーク設計・構築・堅牢化を担当。 四半期ごとのセキュリティ監査とギャップ分析、優先度をつけた是正報告で顧客の ISO 27001 対応を支援し、 冗長フェイルオーバーを備えた SSL/IPsec リモートアクセスを構築しました。

  • Fortinet
  • Cisco
  • Mikrotik
  • IPsec / SSL VPN
  • ISO 27001
それ以前の経歴 · 2016—2022年

2021年8月 — 2022年10月

ブジッバ(マルタ)

IT サポートスペシャリスト · Pronet Gaming

マルタ拠点の IT インフラ全般(端末・LAN・ファイアウォール・セキュリティ境界)を一手に担当し、 繰り返し起きる障害を定型作業に変える運用手順書を整備しました。

2020年11月 — 2021年

マルサ(マルタ)

IT スペシャリスト · Simply VC

24時間稼働を前提とした PoS ブロックチェーンのバリデータノード基盤を担当。 Prometheus と Grafana による監視・アラートに加え、Bash と Python のデプロイスクリプトで 手作業のノード構築を標準化された手順に置き換えました。

2019年4月 — 2020年11月

ビルキルカラ(マルタ)

IT サポートオフィサー · Computime

顧客環境の Windows Server と Linux の運用管理、PowerShell と Bash による診断・パッチ確認・ ユーザー払い出しの自動化、Azure 上のサーバーと Microsoft 365 Exchange テナントの管理を担当しました。

2016年4月 — 2018年9月

パオラ(マルタ)

コンピュータエンジニアリング・アシスタント · Transport Malta

政府機関でのキャリア初期。LAN の保守、ハードウェアサポート、ウェブ管理を担当しました。

資格: CCNA(200-301)· Cisco  ·  MCSA · Microsoft

研修: LPIC-1(101/102)コース受講 · ICE Malta

学歴: MCAST コンピュータシステム・ネットワーク上級ディプロマ(EQF 4)

履歴書全文(PDF)

プロビジョニングの流れ

個人基盤 · ベアメタルから稼働まで

図 1 — パイプライン すべての層を Git で宣言
  1. Proxmox 物理ホスト 1 台 — 障害の範囲もここまで
  2. Terraform + Ansible VM 5 台を作成し、設定を適用
  3. K3s VM 4 ノード構成(コントロールプレーン 1)
  4. ArgoCD Git から 15 アプリを同期
  5. アプリケーション MetalLB と Longhorn 上で 20 以上のサービス

監視

Prometheus · メトリクスと自作エクスポーター

Grafana · ワークロードごとのダッシュボード

Alertmanager · Discord へ通知

主な制作物

業務外で構築・運用 · 主要 3 件 · 小規模 3 件

kubernetes-platform 稼働中

インフラストラクチャ

セルフホスト型 Kubernetes 基盤

Proxmox ホスト 1 台の上で動く 4 ノードの K3s クラスタ。すべての層を Git で宣言しています。

詳細を見る
課題
1 台のサーバー上で 20 以上のサービスを運用しており、変更はすべて手作業でした。再現性がなく、作り直すには文書化されていない手順を一つずつ思い出す必要がありました。
実装内容
Terraform で VM を作成し、Ansible で 4 ノードの K3s クラスタを構築、ArgoCD がすべてのワークロードを Git から同期します。あわせて MetalLB と Nginx Ingress、スケジュールスナップショット付きの Longhorn、TLS のための cert-manager 内部 CA、自作エクスポーターと Discord 通知を含む Prometheus / Grafana / Alertmanager を構成しました。Longhorn が複製するのはクラスタ内の VM 間であり、その VM が同じ物理マシン上にある以上、これはノードやディスクの故障に備えるもので、ホストの停止には備えられません。
成果
15 のアプリケーションを Git から同期(このリポジトリから 12 件、WyrmHost と Wyrmtable の環境別リポジトリから 3 件)。構成のずれは自動で修正され、本番反映はプルリクエスト経由です。ベアメタルからの再構築は「思い出しながらの週末作業」ではなく、8 手順の手順書として文書化されています。下に並ぶ 4 件の障害が、その手順書が何を扱い、何を扱わないかを決めました。
  • Terraform
  • Ansible
  • K3s
  • ArgoCD
  • Prometheus
  • 構成図
  • 詳細説明はご要望に応じて
  • リポジトリは非公開
クラスタ構成

クラスタ構成

Proxmox ホスト — 物理マシン 1 台

  • k3s-master コントロールプレーン · VM
  • k3s-worker-1 ワーカー · VM
  • k3s-worker-2 ワーカー · VM
  • k3s-worker-3 ワーカー · VM

wings-vm · Docker ホスト(クラスタ外)

  • MetalLB + Nginx Ingress · 安定したアドレス割り当て
  • Longhorn · レプリケーションとスケジュールスナップショット

Longhorn はクラスタ内の VM 間でボリュームを複製するため、ノードやディスクの 故障には対応できます。ただし 5 台の VM はすべて同じ物理マシン上にあり、 Proxmox ホスト自体は単一障害点のままです。ホストを失えばすべてを同時に失います。

1 台のホスト上に VM 5 台。うち 4 台がクラスタ、1 台がゲームサーバー用です。

図 2 — アプリケーション 1 件の構成

図 2 — アプリケーション 1 件の構成 リソースグラフ:homelab リポジトリが vaultwarden の ArgoCD アプリケーションを構成し、Deployment・Service・Ingress・Certificate・PVC を保持します。それぞれ Pod、内部 CA が発行した TLS Secret、Longhorn ボリュームへとつながります。 GIT ARGOCD RESOURCES RUNTIME repo homelab application vaultwarden deployment vaultwarden service vaultwarden ingress · https vaultwarden certificate · cert-manager vaultwarden-tls pvc · longhorn vaultwarden-data pod vaultwarden secret · issued by the internal CA vaultwarden-tls volume · daily snapshot, retain 7 longhorn
15 件のうちの 1 つ、vaultwarden アプリケーションと ArgoCD が同期するリソース一式です。TLS を担う cert-manager の証明書と、データを保存する Longhorn のボリュームまで含みます。

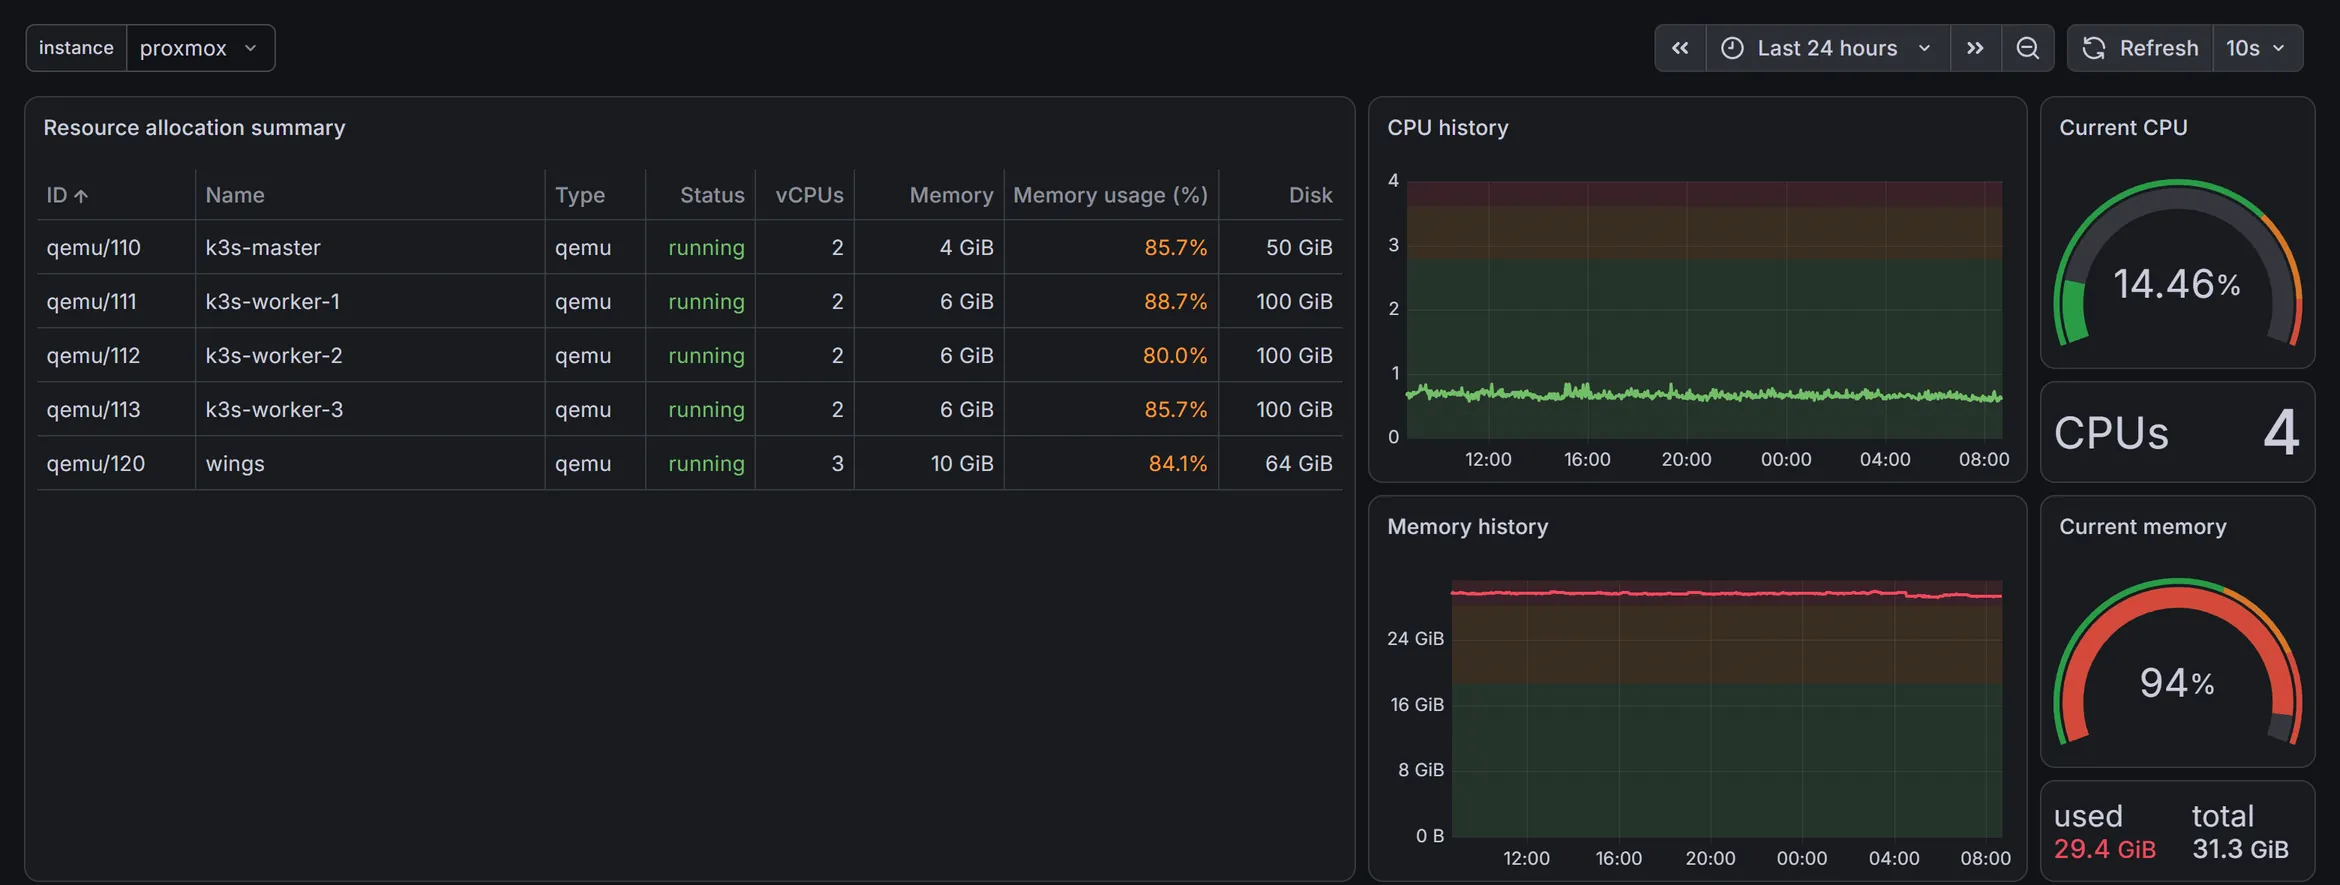
図 3 — 同じ 5 台の VM を、実測で

Proxmox 用エクスポーターのメトリクスを表示する Grafana ダッシュボード。稼働中の QEMU ゲスト 5 台が一覧表示されている。k3s-master は 2 vCPU・4 GiB でメモリ 85.7%、k3s-worker-1〜3 は各 2 vCPU・6 GiB で 88.7%・80.0%・85.7%、wings は 3 vCPU・10 GiB で 84.1%。右側にはホストの 24 時間の CPU 履歴(4 コア中ほぼ 1 コア分)と、上限近くで横ばいのメモリ履歴。ゲージは CPU 14.46%、メモリ 94%(31.3 GiB 中 29.4 GiB 使用)を示している。 (新しいタブで原寸のダッシュボードを開きます)
上の構成図を Prometheus 側から見たものです。自分で動かしている Proxmox 用エクスポーターが データ元で、同じ 5 台のゲストが並んでいます。下の「次の計画」で物理ホストの追加を最初に 挙げている理由もここにあります — ホストの 31.3 GiB のうち 94% が使用済みで、 メモリのグラフは丸一日その上限に張り付いたままです。CPU は 4 コアの 14% で、制約になっていません。 2026年9月時点。
実際の定義ファイルを見る
terraform/main.tf 1 つの map からすべての VM
resource "proxmox_virtual_environment_vm" "vm" {
  for_each = var.vms

  name      = each.key
  node_name = var.proxmox_node
  vm_id     = each.value.vmid

  cpu {
    cores = each.value.cores
    type  = each.value.cpu_type
  }
  memory {
    dedicated = each.value.memory
  }

  # The clone source is only used at creation time. The original
  # template VM may no longer exist, so ignore drift here to avoid
  # forcing VM replacement (which would destroy game-server data)
  # on routine changes like resizing.
  lifecycle {
    ignore_changes = [clone]
  }
}
5 台の VM は変数の map に対する 1 つの for_each から生成されるため、 ノードを増やすのは resource ブロックの追加ではなく入力を数行足すだけです。 lifecycle の指定があるのは、古いクローン参照が残っていると 稼働中の VM が作り直され、ゲームサーバーのデータごと失われてしまうからです。
kubernetes/argocd/apps.yml このリポジトリの 12 件のうち 1 つ
apiVersion: argoproj.io/v1alpha1
kind: Application
metadata:
  name: vaultwarden
  namespace: argocd
spec:
  source:
    repoURL: https://github.com/ToonKnight/homelab.git
    targetRevision: HEAD
    path: kubernetes/vaultwarden
  destination:
    server: https://kubernetes.default.svc
    namespace: vaultwarden
  syncPolicy:
    automated:
      prune: false      # deleting is never automatic
      selfHeal: true    # a hand-edit is reverted to Git
    syncOptions:
      - CreateNamespace=true
図 2 の元になっている Application です。selfHeal があることで 「Git で宣言している」が努力目標ではなく事実になります — 手でクラスタを変更しても 元に戻されます。prune を意図的に無効にしているのは、 マニフェストの削除が判断を伴わずにボリュームを消してしまわないためです。
DISASTER-RECOVERY.md ベアメタルからクラスタ稼働まで
手順プレイブック内容所要
100-provision-vmsTerraform で Proxmox 上に VM を作成約 3 分
201-common全ノードのパッケージとカーネル設定約 3 分
302-k3s-masterK3s コントロールプレーンを構築約 2 分
403-k3s-workersワーカー 3 台を参加させる約 2 分
504-k3s-addonsMetalLB・Nginx Ingress・Longhorn・Prometheus 一式約 10 分
605-kubernetes-appsアプリケーションのマニフェストを適用約 2 分
7インラインArgoCD の導入・Ingress・このリポジトリの 12 件の Application約 3 分
806-wingsゲームサーバー用 VM:Docker と Wings デーモン約 3 分
手順書に記載された合計(この後に手動作業が続きます)約 25〜30 分
同じ手順書には、復旧されないものも明記しています。Longhorn のボリューム、 AdGuard の設定と統計、Smokeping の履歴は、完全に破棄した場合に失われるものとして、 Git で安全に管理されているものと並べて書かれています。 手順の隣に欠落を書いておくことが、深夜にこの文書を信頼できる理由です。
wyrmhost 開発中

プラットフォーム自動化

WyrmHost

自動でサーバーが用意されるゲームサーバーホスティング。プランを選んで決済すると、そのまま起動します。

詳細を見る
課題
ゲームサーバーを販売するには、注文ごとにサーバーを用意する必要があります。手作業では規模を拡大できず、夜間の注文にも対応できません。
実装内容
ストアフロント、Stripe 決済、キューワーカー、そしてサーバーを作成・起動するパネル API 呼び出しまでを構築しました。利用しているパネル向けのプロバイダーが存在しなかったため、API に合わせて自分で移植しています。環境ごとに独立した GitOps リポジトリを持ち、ArgoCD のガードレールと手動プロモーションで本番へ反映します。
成果
決済からプレイ可能なサーバー起動まで約 46 秒、手作業はゼロです。これは実際の注文の平均ではなく、テスト購入 1 件でエンドツーエンドに計測した値です。以前は新規サーバーが初回起動のたびに落ちる原因だったライセンス同意も、自動で処理されます。
  • Laravel
  • Stripe
  • Docker
  • ArgoCD
  • REST API
プロビジョニングの手順
  1. 決済 プランを選んで支払い
  2. 請求確定 プロビジョニングジョブを投入
  3. サーバー作成 ポート割り当てとファイル配置
  4. ライセンス同意 自動処理のうえ起動
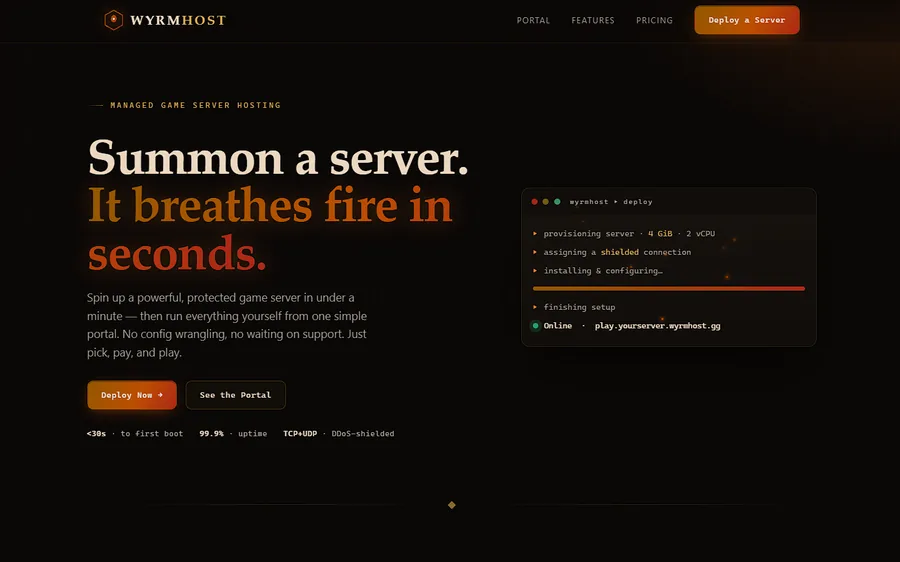
  5. 起動完了 接続可能 — 合計約 46 秒
テスト購入 1 件でエンドツーエンドに計測した値です。
WyrmHost のストアフロント。「Summon a server. It breathes fire in seconds.」という見出しと Deploy Now ボタン、サーバーが起動していく様子を示すデプロイコンソールが並ぶ暗い配色のページ。 ストアフロントの原寸画像を開きます(新しいタブ)
お客様が購入する画面で、上の手順の入口にあたります。プロビジョニング自体はキューワーカーが実行するため、決済から起動までの間に画面として見えるものはありません。
wyrmtable 公開中

プロダクト · フルスタック

Wyrmtable

テーブル全体で 1 つのゲーム状態を共有できる、リアルタイムの TRPG ツールです。

詳細を見る
課題
自分がゲームを進行するとき、マップも行動順も全員のキャラクターシートも私のノート PC の中にあり、参加者は 1 つの画面をのぞき込む形になっていました。自分のシートを見ることも、自分でダイスを振ることも、私に操作を頼まないとできませんでした。
実装内容
WebSocket でテーブルの状態を共有し、サーバー側で判定するダイス、戦闘トラッカー、キャラクターインポートを備えたブラウザツールです。コンテナ化、バージョン管理されたマイグレーション、失敗を検知するアラート付きの夜間バックアップ、専用の Grafana ダッシュボードまで、開発と運用のすべてを担当しています。
成果
wyrmtable.eu で一般公開中です。ポートを開放せず Cloudflare Tunnel 経由で公開し、Pod は NetworkPolicy で制限、非 root で実行、認証にはレート制限をかけています。リリースはイメージタグを固定し、手動で反映します。
  • Next.js
  • TypeScript
  • Socket.IO
  • PostgreSQL
  • Kubernetes
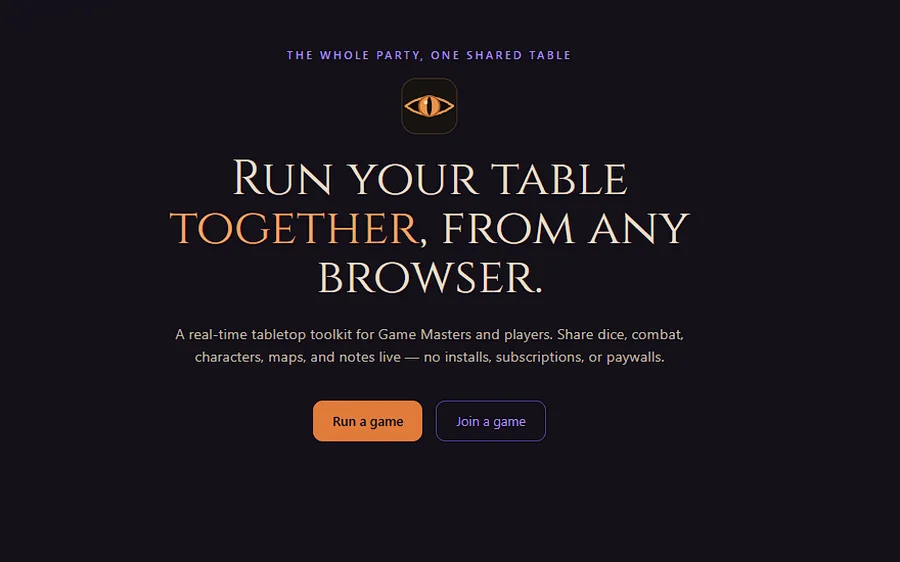
Wyrmtable のサイト。「Run your table together, from any browser」という見出しと、Run a game・Join a game のボタンが並ぶ暗い配色のページ。 Wyrmtable の原寸画像を開きます(新しいタブ)
wyrmtable.eu の公開トップページです。セッション中の画面はログインの内側にあるため、ここには掲載していません。
小規模プロジェクト 3 件
fpl-ai · trading-harness · raid-companion
  • fpl-ai

    データ · 機械学習

    Fantasy Premier League の公式データを取り込み、期待ポイントを予測して移籍を提案します。実行はせず提案のみを行う設計です。作業の大半はデータの整備でした。単位の不一致や信頼できない上流カラムを見つけておかないと、すべての提案が静かに誤ったものになっていました。

    • Python
    • Pandas
    • Kubernetes
    稼働中
  • trading-harness

    研究 · システム

    ウォークフォワード検証、現実的な手数料とスリッページのモデル化、リスク上限、そしてエラーだけでなく無応答にも反応するアラートを備えた暗号資産の研究基盤です。結果は率直に言って優位性なし。勝率と損益比の積が 1.0、つまりランダムなエントリーと同じ特徴を示しました。それを正しく測定して手を止めたことが、さらなるチューニングよりも価値がありました。

    • Python
    • バックテスト
    • GitHub Actions
    研究
  • raid-companion

    デスクトップ · ツール

    レイド用のデスクトップ補助ツールです。単一の実行ファイルとして配布しており、利用者はインストール手順を読まずにダブルクリックするだけで使えます。

    • Electron
    • TypeScript
    • Node.js
    リリース済み

障害対応の記録

4 件の記録

何が起きて、その後どう変えたか 原因を特定し記録しています
sev-1

シンプロビジョニング領域が 100% に達し、全 VM が停止

事象
ストレージプールが完全に埋まり、書き込みが停止。ホスト上のすべての VM が同時に応答しなくなりました。
原因
ハイパーバイザーが discard=ignore で動作しており、ゲスト側の TRIM がホストに届いていませんでした。削除済みブロックが回収されず、VM 側でいくら空けてもプールは増える一方でした。
対応
discard のパススルーを有効化し、fstrim で未回収の領域を解放して使用率を上限以下に戻しました。
再発防止
プール使用率を監視対象にしたため、次に上限へ近づいたときは障害ではなく警告として届きます。回収処理を静かに無効化する設定は、切迫するまで表に出てきません。ゲスト側だけでなく経路全体を確認することが教訓です。
sev-1 メモリ不足のノードが自ら停止 解決済み
事象
ワークロードを 1 つ退避させる代わりに、ノード全体が応答しなくなりました。
原因
メモリを大量に消費するワークロードがノードの RAM を使い切りました。kubelet の退避しきい値が未設定だったため、退避を実行する余力が残る前に限界に達していました。
対応
退避しきい値とシステム予約を明示的に設定し、kubelet が常に動ける余力を確保。あわせて実測値に基づいてワークロードのリソース上限を見直しました。
再発防止
メモリを食うポッドは「ポッドの問題」で収まり、ノード全体の問題にはなりません。退避設定は障害後に足すものではなく、クラスタ構築の一部としています。
sev-2 録画システムが再起動のたびに記録を失う 解決済み
事象
アプリケーションが把握していない録画ファイルがディスク上に溜まり続け、クリーンアップが動きませんでした。
原因
録画システムのデータベースが emptyDir 上に置かれていました。Pod が再起動するたびに索引が消える一方、録画ファイル自体はディスクに残っていました。
対応
データベースを永続ボリュームへ移し、保持期間を推測ではなく実測の書き込み量に基づいて設定しました。
再発防止
「再起動しても残るはず」と考えているものには、マニフェスト上に PVC が必要です。ステートフルなワークロードはすべて同じ観点で見直しました。
sev-2 メモリ逼迫時に API サーバーが断続的にタイムアウト 解決済み
事象
API サーバーでデータストアと TLS のタイムアウトが不定期に発生し、明確なきっかけが見当たりませんでした。
原因
コントロールプレーンのノードが空きメモリをほとんど持たず、スワップもない状態でした。データストアが大きくなり、キャッシュが逼迫した状況でクエリが遅くなっていました。
対応
TLS エラーを追いかけるのではなく、ホストのメモリまで遡って原因を特定し、逼迫を解消しました。
再発防止
データストアのサイズを監視対象にし、遅延として表れる前に増加が見えるようにしました。症状は原因から何層も離れた場所に出ます。エラーを出していた指標が、見るべき指標とは限りませんでした。

次の計画

計画段階 — まだ実装していません

計画段階 — まだ実装していません

2026年8月時点

  1. 01

    物理ホストをもう1台

    Longhorn はすでにクラスタの VM 間でボリュームを複製していますが、その VM はすべて同じ Proxmox ホスト上にあり、ホストは単一障害点のままです。2 台に分ければレプリカを別々のマシンに置けるようになり、いつも切り詰めているメモリの余裕も取り戻せます(上の図 3 がその状態で、94% が使用済みです)。ただしこれだけで可用性が確保されるわけではありません。02 と、ロードバランサのアドレスをどう扱うかの検討が必要です。

  2. 02

    コントロールプレーンの冗長化と、クラスタ外へのバックアップ

    コントロールプレーンが1ノードだけという点も、まず直したいところです。複数ノード構成にしたうえで、データベースのバックアップを、保護対象と同じストレージではなくクラスタの外へ送るようにします。

  3. 03

    専用ハードウェア上の推論基盤と、その先の AI 運用支援

    ローカルでのモデル実行は、ディスクと RAM を他のサービスと奪い合うようになった時点でクラスタから外しました。まず専用のハードウェアに戻し、そのうえで一度動かしていた仕組みを作り直します。critical アラートを n8n の Webhook に流し、ローカルモデルを呼び出して自動復旧を試みるものです。6月に外して以降、アラートは Discord に通知するだけになっています。作り直す価値があるのは人を介在させた形 — n8n が診断と対処案を作成し、人が承認し、実行の記録が必ず残る形です。

  4. 04

    Wyrmtable のスケールアウト

    現在セッションの状態は単一プロセスのメモリ上にあるため、アプリは1レプリカで動いています。Socket.IO の背後に Redis アダプタを置けばスケールアウトでき、次の機能としてフォグ・オブ・ウォー付きのバトルマップを予定しています。

技術スタック

業務で、個人基盤で、あるいはその両方で使用

インフラ

  • GCP
  • Terraform
  • Ansible
  • Kubernetes / K3s
  • Helm
  • Docker
  • Proxmox
  • VMware / vCenter
  • Linux
  • Windows Server / AD
  • MetalLB
  • Longhorn
  • cert-manager

ネットワークとセキュリティ

  • HAProxy
  • FortiGate
  • Cisco
  • Mikrotik
  • IPsec / SSL VPN
  • TCP/IP · DNS
  • Vault
  • 最小権限 IAM
  • ISO 27001 監査

デリバリーと監視

  • ArgoCD
  • GitOps
  • GitHub Actions
  • Prometheus
  • Grafana
  • Alertmanager
  • エクスポーター
  • n8n

スクリプティング

  • Python
  • Bash
  • PowerShell

実務

  • Infrastructure as Code
  • 障害の原因分析
  • 災害復旧
  • キャパシティ計画
  • 監視設計
  • ドキュメント作成
連絡先 通常 1 日以内に返信します

基盤をつくり、動かし続けられる人材をお探しですか。

プロビジョニングの仕組みづくりから、深夜の原因調査まで担当します。マルタ在住、現在は Altenar の DevOps インフラエンジニアです。クラウド自動化、Kubernetes、ネットワーク、あるいは空き部屋のラックで動いているものの話まで、お気軽にご連絡ください。